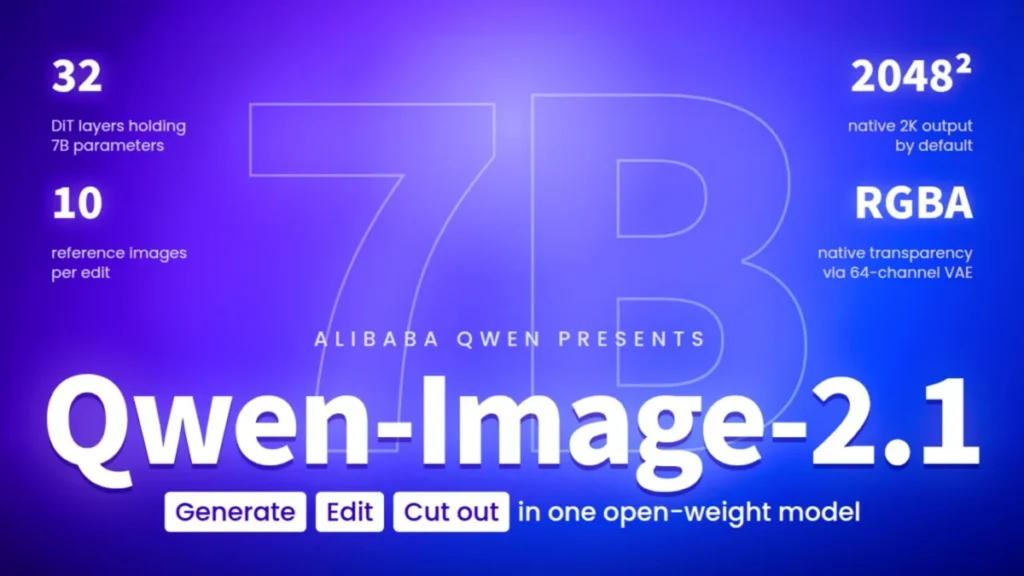
- El modelo cuenta con 7.000 millones de parámetros y licencia abierta para desarrolladores.
- Incorpora un sistema de atención de granularidad mixta con reutilización de caché KV.
- Reduce sustancialmente la latencia en tareas de edición continua e iterativa de imágenes.
- El repositorio de código y los pesos están disponibles en Hugging Face y GitHub.
La división de inteligencia artificial de Alibaba Qwen oficializó el lanzamiento de Qwen-Image-2.1, un modelo fundacional de 7.000 millones de parámetros (7B) diseñado para la generación y edición fotográfica de alta resolución mediante instrucciones de texto y referencias visuales combinadas. La entrega se publica bajo una modalidad de pesos abiertos que permite a laboratorios de investigación y empresas tecnológicas desplegar el sistema en servidores propios sin restricciones restrictivas de uso comercial.
El núcleo del desarrollo reside en la resolución de uno de los cuellos de botella más severos en la síntesis de imágenes por difusión: el costo computacional redundante en procesos interactivos de edición. Tradicionalmente, cuando un usuario introduce una imagen de referencia o solicita modificaciones sucesivas sobre un lienzo digital, los modelos convencionales recalculan el estado latente completo en cada paso de reducción de ruido. Qwen-Image-2.1 introduce un esquema optimizado de atención de granularidad mixta que elimina ese cálculo redundante.
Arquitectura de atención y caché de prefijos
Dentro de la arquitectura de la red, los tokens de texto son procesados con una máscara causal a nivel de token, mientras que los parches de las imágenes emplean una máscara bidireccional a nivel de bloques. El prefijo condicional que contiene las instrucciones textuales y las imágenes de referencia se ubica con antelación al vector latente con ruido. Gracias a esta disposición matemática, los valores de clave y valor (KV cache) permanecen constantes a lo largo de todas las etapas del proceso de desnoizado.
Como resultado directo, el modelo procesa los datos del texto y las imágenes de entrada una única vez en el primer paso de inferencia y reutiliza la memoria intermedia en los pasos subsiguientes. En tareas de edición iterativa con múltiples imágenes de guía, la reducción de tiempo de procesamiento resulta exponencial, habilitando flujos de trabajo en tiempo real en estaciones de trabajo convencionales con GPUs de nivel profesional.
Disponibilidad en repositorios abiertos y aplicaciones
El proyecto ha sido alojado en plataformas colaborativas internacionales como Hugging Face y el portal de código abierto GitHub, en concordancia con los estándares de la Apache Software Foundation. La comunidad de programación cuenta con bibliotecas auxiliares en Python que facilitan la integración directa con entornos como ComfyUI y canalizaciones de Diffusers.
En el marco del acelerado ritmo de avances de inteligencia artificial en el plano global, el aporte de Alibaba refuerza la tendencia hacia modelos abiertos que disputan el liderazgo frente a soluciones propietarias cerradas. Las pruebas preliminares demuestran que Qwen-Image-2.1 conserva una fidelidad tipográfica notable en renderizado de texto dentro de imágenes, manejo preciso de iluminación ambiental y coherencia en anatomía compleja, consolidándose como una herramienta versátil para diseño gráfico, modelado de productos y aplicaciones de realidad extendida.
Perspectivas técnicas en computación visual y edición generativa
El lanzamiento marca un punto de inflexión en la democratización del renderizado visual de alta resolución. Al permitir que creadores independientes operen el modelo sin pagar suscripciones mensuales por API a gigantes de la nube, Qwen-Image-2.1 impulsa la autonomía digital de estudios de animación, agencias publicitarias y desarrolladores de videojuegos. Además, la capacidad de procesar múltiples imágenes de entrada facilita el diseño de personajes consistentes a través de diferentes planos y vestimentas.
Los ingenieros del equipo de Qwen indicaron que continuarán refinando los módulos de adaptación de estilo LoRA y cuantizaciones de 4 bits para reducir el consumo de memoria VRAM a menos de 12 gigabytes, haciendo factible la ejecución local en tarjetas gráficas para el consumidor masivo. Este esfuerzo de ingeniería subraya la intensa rivalidad tecnológica entre los polos de desarrollo de Asia y Occidente por dominar las herramientas fundacionales de la era digital.