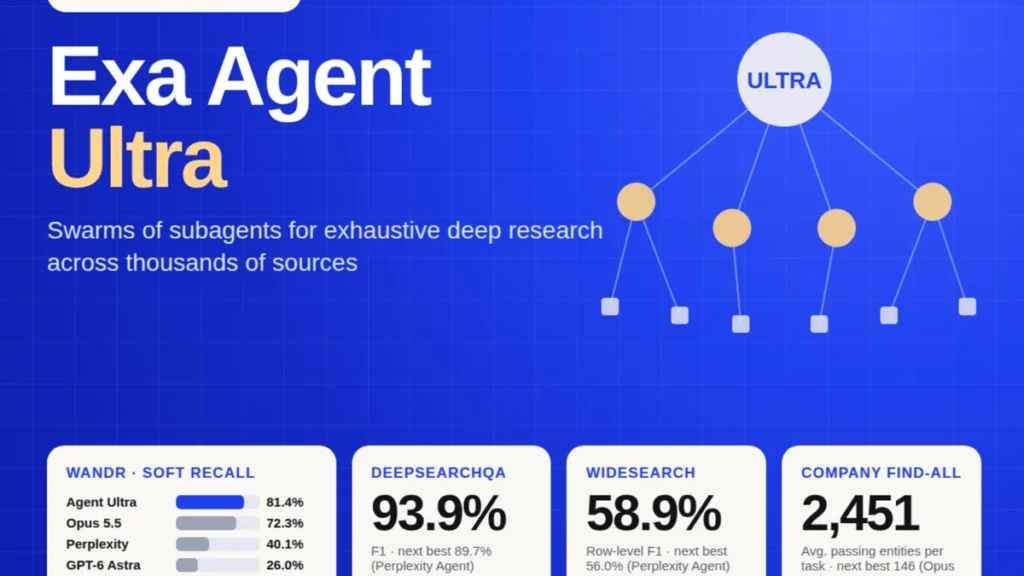
- Exa presentó su API Agent Ultra para coordinar enjambres masivos de subagentes autónomos.
- El sistema alcanzó un 81,4% de eficacia en el benchmark WANDR, superando a Opus 5.5.
- La arquitectura está diseñada para construir listas exhaustivas y recolectar datos complejos.
- Los desarrolladores pueden fijar límites estrictos de presupuesto y duración por tarea.
La compañía de infraestructura de búsqueda para inteligencia artificial Exa presentó oficialmente este 26 de septiembre de 2026 su nueva interfaz de programación Agent Ultra. La herramienta introduce un paradigma de orquestación basado en enjambres de subagentes paralelos, diseñado para resolver una de las limitaciones más notorias de los modelos de lenguaje contemporáneos: la recopilación exhaustiva de información dispersa y la construcción de listas estructuradas a escala web sin omitir datos críticos.
A diferencia de los agentes conversacionales convencionales que ejecutan búsquedas secuenciales individuales y sufren de degradación de contexto tras varias iteraciones, Agent Ultra despliega docenas de hilos especializados que rastrean simultáneamente bases de datos, repositorios técnicos y registros corporativos. Cada subagente evalúa fuentes de forma independiente y valida criterios de filtrado rigurosos antes de consolidar los hallazgos en esquemas JSON unificados.
Rendimiento superior en evaluaciones y reducción de costos
En las pruebas de rendimiento técnico estandarizadas divulgadas en repositorios de arXiv, Agent Ultra obtuvo una puntuación del 81,4% en WANDR, el exigente benchmark de recopilación profunda desarrollado por Perplexity, superando con holgura el 72,3% registrado por Claude Opus 5.5 y el 26% de GPT-6 Astra. En la evaluación DeepSearchQA, diseñada por investigadores de Google DeepMind para medir búsquedas de pasos múltiples, el sistema de Exa alcanzó un 93,9% de precisión F1, operando con un coste económico hasta un 46% inferior por tarea que los modelos propietarios de la competencia.
En tareas complejas de identificación masiva de empresas y patentes (Company Find-All), la arquitectura logró identificar un promedio de 2.451 entidades válidas por consigna, frente a las apenas 146 entidades localizadas por los sistemas basados en agentes lineales, marcando una brecha de rendimiento cuantitativo sin precedentes en la minería de datos web.
Casos de uso corporativo y control de ejecución
Exa orienta su nueva API hacia tres segmentos estratégicos: laboratorios de inteligencia artificial que requieren curar conjuntos de datos limpios para entrenamiento continuo, instituciones financieras dedicadas al análisis de riesgos regulatorios (KYC) y equipos comerciales que elaboran mapas de mercado con enlaces de respaldo verificables.
El auge de herramientas autónomas de exploración interactúa con la constante evolución de los sistemas inteligentes, en un ecosistema donde las grandes corporaciones analizan agentes de OpenAI e intentos de acceso a portales gubernamentales y los líderes del hardware como Nvidia defienden delegar tareas y memoria en la inteligencia artificial.
Para garantizar previsibilidad operativa, la API incorpora parámetros obligatorios de control presupuestario y temporal, permitiendo a los ingenieros definir topes máximos de gasto en dólares y duración en segundos, garantizando la entrega de los resultados compilados hasta el momento exacto en que se alcance el límite establecido.
Métricas de evaluación comparativa y precisión analítica
En el benchmark WideSearch, diseñado específicamente para evaluar la amplitud de búsqueda sin perder coherencia contextual, Agent Ultra alcanzó un 58,9% de precisión F1 a nivel de fila, superando tanto a Perplexity Agent (56%) como a los motores autónomos basados en modelos cerrados. El sistema sobresale particularmente al estructurar tablas comparativas extensas, donde los agentes tradicionales suelen truncar las respuestas tras procesar varias decenas de enlaces debido a limitaciones de memoria activa.
Los desarrolladores de Exa explicaron que el motor de evaluación implementa jueces basados en modelos generativos de última generación que auditan cada celda generada contra la URL de origen correspondiente. Esta verificación automatizada elimina las alucinaciones habituales en tareas de enriquecimiento de datos y garantiza que las organizaciones financieras o académicas puedan auditar cada dato recopilado mediante citas textuales directas.