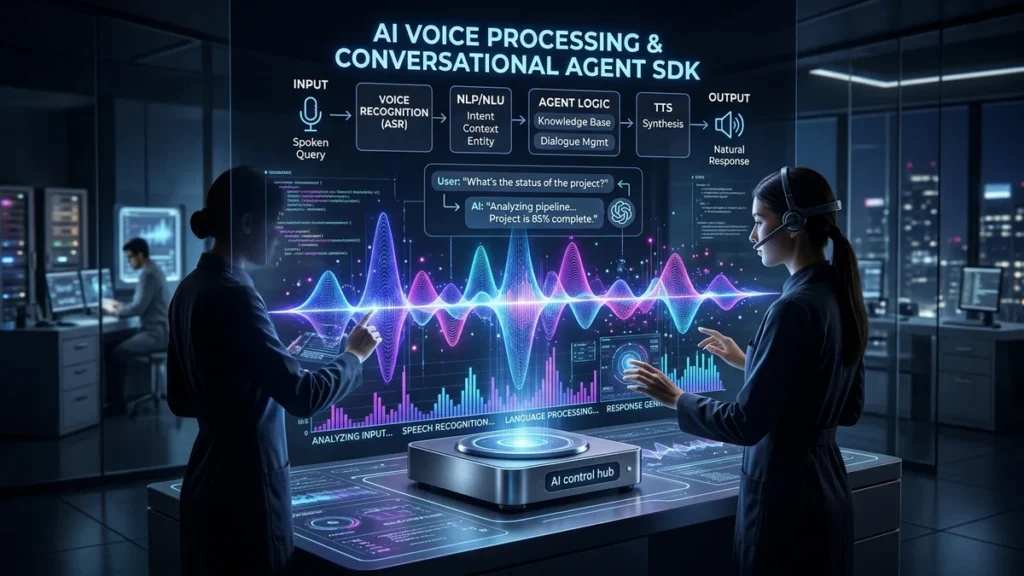
- Voxtral 3 unifica modelos de habla a texto (STT) y síntesis de voz (TTS) en un solo pipeline.
- El nuevo SDK permite crear agentes conversacionales de voz con latencia menor a un segundo.
- Incluye soporte nativo para más de 50 idiomas con detección automática de interrupciones.
- Ofrece opciones de despliegue soberano en servidores locales para empresas y gobiernos.
La reconocida firma europea de inteligencia artificial da un salto disruptivo en el procesamiento multimodal luego de que Mistral AI lanza Voxtral 3, una suite integral de tecnologías de audio que elimina la complejidad de coordinar múltiples proveedores de voz y razonamiento, reuniendo transcripción de ultraprecisión, generación de voz emocional y un potente kit de desarrollo para agentes conversacionales en tiempo real. de acuerdo con informes de World Wide Web Consortium.
El ecosistema, detallado en los repositorios de desarrollo y presentado formalmente ante la comunidad tecnológica en Mistral AI, aborda uno de los cuellos de botella más severos en la interacción por voz: la fragmentación entre la transcripción acústica (STT), la inferencia del modelo de lenguaje y la posterior síntesis sintética (TTS), sustituyéndola por una arquitectura continua de baja latencia. de acuerdo con informes de World Wide Web Consortium.
Arquitectura técnica y capacidades de la familia Voxtral
La propuesta técnica se estructura en tres componentes principales diseñados para responder a diferentes perfiles de demanda empresarial:
Transcripción y diarización con Voxtral Small Transcribe
El modelo insignia de transcripción soporta más de 50 idiomas y cuenta con diarización de hablantes nativa, permitiendo reconocer con exactitud quién habla en entornos ruidosos o llamadas grupales. Asimismo, introduce un mecanismo de detección de fin de turno (end-of-turn) que identifica de inmediato cuándo el interlocutor culminó su idea, evitando pausas artificiales o interrupciones indebidas.
Expresividad emocional y adaptación de voz en Voxtral TTS
En el apartado de salida sonora, los modelos Voxtral Mini TTS y Voxtral Speech generan cadencias vocales naturales a través de 35 idiomas y más de 50 variantes dialectales. Permite ajustar ritmo, énfasis y tono afectivo, además de incorporar clonación de voz profesional mediante muestras breves de audio, en sintonía con las herramientas analizadas en nuestras publicaciones sobre la detección y control ético de voces generadas por inteligencia artificial.
Voice Agent SDK y soberanía de datos corporativos
El gran diferencial de la entrega radica en su Voice Agent SDK, diseñado para orquestar llamadas a bases de datos corporativas y herramientas externas mientras el agente sostiene una conversación fluida en vivo. Con una respuesta de latencia subsegundo, el sistema gestiona interrupciones espontáneas del usuario sin desorientarse del contexto.
Ventajas competitivas del procesamiento de voz unificado
La integración fluida de modelos de reconocimiento y síntesis acústica en Voxtral 3 representa un avance cualitativo frente a las arquitecturas fragmentadas tradicionales, donde cada conversión entre audio y texto añadía latencias perceptibles que destruían la naturalidad de la conversación humana. Al optimizar los pesos neuronales para inferencia rápida, los desarrolladores pueden implementar asistentes telefónicos empresariales capaces de resolver reclamos complejos en segundos.
Asimismo, la capacidad de desplegar el sistema en servidores privados garantiza que las conversaciones confidenciales de clientes y usuarios permanezcan bajo el control exclusivo de la organización, cumpliendo con las normativas europeas más estrictas de protección de datos personales.
Escalabilidad técnica y casos de uso en la industria global
La adopción de Voxtral 3 promete transformar radicalmente la atención al cliente en sectores con alta demanda transaccional como aerolíneas, banca en línea y plataformas de salud digital, donde los usuarios esperan respuestas orales instantáneas, precisas y sin pausas robóticas artificiales. La capacidad de inferir intenciones complejas a partir de entonaciones o titubeos acústicos permite que los agentes de voz actúen con una empatía operativa sin precedentes.
Asimismo, los equipos de desarrollo tecnológico destacan la optimización del consumo de memoria en tarjetas gráficas (GPUs), lo que reduce considerablemente el costo de computación por minuto de llamada procesada y democratiza el acceso a inteligencia artificial de voz de nivel empresarial para pequeñas y medianas empresas.
Ventajas competitivas del procesamiento de voz unificado
La integración fluida de modelos de reconocimiento y síntesis acústica en Voxtral 3 representa un avance cualitativo frente a las arquitecturas fragmentadas tradicionales, donde cada conversión entre audio y texto añadía latencias perceptibles que destruían la naturalidad de la conversación humana. Al optimizar los pesos neuronales para inferencia rápida, los desarrolladores pueden implementar asistentes telefónicos empresariales capaces de resolver reclamos complejos en segundos.
Asimismo, la capacidad de desplegar el sistema en servidores privados garantiza que las conversaciones confidenciales de clientes y usuarios permanezcan bajo el control exclusivo de la organización, cumpliendo con las normativas europeas más estrictas de protección de datos personales.
Fiel a la filosofía de autonomía europea, Mistral ofrece la suite tanto a través de sus APIs en la nube comunitaria como para implementación en servidores locales de las empresas, garantizando la privacidad absoluta de los datos confidenciales en sectores bancarios, de salud y gobernanza digital.